我们把全局事务(Global Transaction)或外部事务(External Transaction)限定为单个服务使用多个数据源场景的分布式解决方案。理论上真正的全局事务并没有“单个服务”的约束,它本来就是 DTP(Distributed Transaction Processing,分布式事务处理)模型中的概念,但是我们在这里讨论的是一种在分布式环境下仍然追求强一致性的事务处理方案,对于多节点且需要相互调用彼此服务的场景是极不合适的。这种方案几乎只适用于单服务多数据源的场合中。
XA 规范与核心角色
为了解决单个服务操作多个数据源时,如何保证多个数据源的事务同时成功或者同时回滚的问题,X/Open 组织定义了 XA 规范。该规范是一个与编程语言无关的底层架构设计,确立了全局事务的两个核心角色:
- Transaction Manager(TM/全局事务管理器): 全局事务的“总指挥”。它负责统筹全局,告诉大家什么时候提交,什么时候回滚。
- Resource Manager(RM/局部资源管理器): 全局事务中的“执行者”。通常就是底层的数据库(如 MySQL、Oracle)或消息队列(如 ActiveMQ),它们负责执行本地的真实事务,并听从 TM 的指令。
- XA 接口: TM 和 RM 之间沟通的“标准语言”(基于两阶段提交的底层协议)。XA 接口是双向的,能在一个事务管理器和多个资源管理器之间形成通信桥梁,通过协调多个数据源的一致动作,实现全局事务的统一提交或统一回滚。
JTA:Java 中的 XA 实现
因为 XA 规范提出时还没有 Java 语言,所以 Java 后续自己提出了一套 API,叫 JTA(Java Transaction API,JSR 907)。JTA 就是 XA 规范在 Java 中的官方标准接口,它有两个主要的接口:
- 事务管理器的接口:
javax.transaction.TransactionManager,用于 Java EE 服务器提供容器事务(由容器自动负责事务管理);JTA 还提供了另外一套javax.transaction.UserTransaction接口,用于通过程序代码手动开启、提交和回滚事务。 - 满足 XA 规范的资源定义接口:
javax.transaction.xa.XAResource,任何资源(JDBC、JMS 等)如果想要支持 JTA,只要实现XAResource接口中的方法即可。
JTA 原本是 Java EE 中的技术,一般情况下应该由 JBoss、WebSphere、WebLogic 这些 Java EE 容器来提供支持,但现在 Bitronix、Atomikos 和 JBossTM(以前叫 Arjuna)都是以 JAR 包的形式实现了 JTA 的接口,称为 JOTM(Java Open Transaction Manager,Java 开源事务管理器),使得我们也能够在 Tomcat、Jetty 这样的 Java SE 环境下使用 JTA。
两阶段提交(2PC)
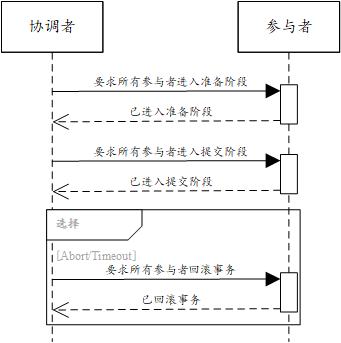
为了解决全局事务中数据一致性的问题,XA 将事务提交拆分为两个阶段:
- 准备阶段: 又叫做投票阶段,在这一阶段,协调者询问事务的所有参与者是否准备好提交,参与者如果已经准备好提交则回复 Prepared,否则回复 Non-Prepared。对数据库来说,准备操作是在重做日志中记录全部事务提交操作所需要的内容,它与本地事务中真正提交的区别只是暂不写入最后一条 Commit Record 而已,这就意味着在做完数据持久化后并不立即释放隔离性,仍继续持有锁,维持数据对其他非事务内观察者的隔离状态。
- 提交阶段: 又叫做执行阶段,协调者如果在上一阶段收到所有事务参与者回复的 Prepared 消息,则先自己在本地持久化事务状态 Commit,然后向所有参与者发送 Commit 指令,让所有参与者立即执行提交操作;否则,只要任意一个参与者回复 Non-Prepared 消息,或任意一个参与者超时未回复,协调者就会在自己完成事务状态为 Abort 的持久化后,向所有参与者发送 Abort 指令,让参与者立即执行回滚操作。对于数据库来说,这个阶段的提交操作很轻量,仅仅是持久化一条 Commit Record 而已,通常能够快速完成;只有收到 Abort 指令时,才需要根据回滚日志清理已经提交的数据,这可能是相对重负载的操作。
以上这两个过程被称为“两段式提交”(2 Phase Commit,2PC)协议,而它要想成功保持一致性还需要一些其他的前提条件:
- 必须假设网络在提交阶段的短时间内是可靠的,即提交阶段不会丢失消息;同时也假设网络通信在全过程都不会出现误差,即可以丢失消息,但不会传递错误的消息——XA 的设计目标并不是解决诸如拜占庭将军一类的问题。在两阶段提交中,投票阶段失败了可以补救(回滚),提交阶段失败了则无法补救(不再改变提交或回滚的结果,只能等崩溃的节点重新恢复),因此该阶段耗时应该尽可能短,这也是在尽量控制网络风险。
- 必须假设因为网络分区、机器崩溃或者其他原因而导致失联的节点最终能够恢复,不会永久性地处于失联状态。由于在准备阶段已经写入了完整的重做日志,所以失联机器一旦恢复,就能够从日志中找出已经准备妥当但并未提交的事务数据,进而向协调者查询该事务的状态,确定下一步应该进行提交还是回滚操作。
上面所说的协调者、参与者通常都是由数据库自己来扮演的,不需要应用程序介入,协调者一般是在参与者之间选举产生,而应用程序对于数据库来说只扮演客户端的角色。
两阶段提交存在的问题
- 单点问题: 协调者在两段式提交中具有举足轻重的作用。协调者等待参与者回复时可以有超时机制,允许参与者宕机,但参与者等待协调者指令时无法做超时处理——一旦宕机的不是某个参与者,而是协调者本身,所有参与者都会受到影响。如果协调者一直没有恢复,没有正常发送 Commit 或 Rollback 指令,那所有参与者都必须一直等待。
- 性能问题: 在两段式提交过程中,所有参与者相当于被绑定为一个统一调度的整体,期间要经过两次远程服务调用、三次数据持久化(准备阶段写重做日志,协调者做状态持久化,提交阶段在日志写入提交记录),整个过程要持续到参与者集群中最慢的那一个处理操作结束为止,这决定了两段式提交的性能通常较差。
- 一致性风险: 前面已经提到,两段式提交的成立是有前提条件的,当网络稳定性和宕机恢复能力的假设不成立时,仍可能出现一致性问题。“FLP 不可能原理”证明了如果宕机最终不能恢复,那就不存在任何一种分布式协议可以正确地达成一致性结果。网络稳定性带来的一致性风险指的是:尽管提交阶段时间很短,但这仍是一段明确存在的危险期——如果协调者在发出准备指令后,根据收到的各参与者回复确定事务状态是可以提交的,于是先持久化事务状态并提交了自己的事务,这时候如果网络忽然断开,无法再向所有参与者发出 Commit 指令,就会导致部分数据(协调者的)已提交,但部分数据(参与者的)未提交,并且没有办法回滚,产生数据不一致的问题。
三阶段提交(3PC)
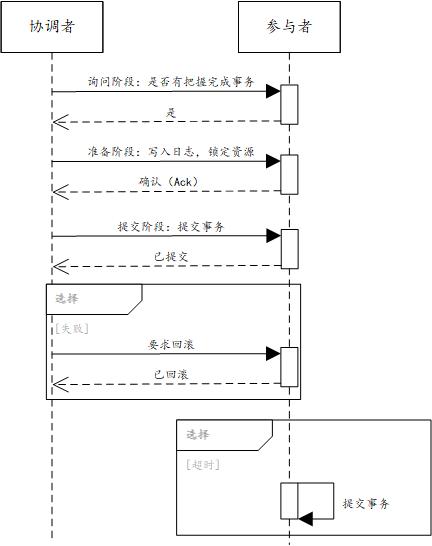
为了缓解两阶段提交中协调者的单点问题和准备阶段的性能问题,后续又发展出了“三段式提交”(3 Phase Commit,3PC)协议。三段式提交把原本两段式提交的准备阶段再细分为两个阶段,分别称为 CanCommit、PreCommit,把提交阶段改称为 DoCommit 阶段。其中新增的 CanCommit 是一个询问阶段,即协调者让每个参与的数据库根据自身状态,评估该事务是否有可能顺利完成。将准备阶段一分为二的理由是:准备阶段是重负载的操作,一旦协调者发出开始准备的消息,每个参与者都将马上开始写重做日志,其所涉及的数据资源即被锁住,如果此时某一个参与者宣告无法完成提交,相当于大家都做了一轮无用功。所以增加一轮询问阶段,如果都得到了正面的响应,那事务能够成功提交的把握就比较大,这也意味着因某个参与者提交时发生崩溃而导致大家全部回滚的风险相对变小。因此,在事务需要回滚的场景中,三段式提交的性能通常比两段式提交要好很多;但在事务能正常提交的场景中,两者性能都很差,甚至三段式因为多了一次询问,还要稍微更差一些。
同样也是由于事务失败回滚的概率变小,在三段式提交中,如果 PreCommit 阶段之后发生了协调者宕机,即参与者没有等到 DoCommit 消息,默认操作策略将是提交事务而不是回滚事务或继续等待,这就相当于避免了协调者单点问题的风险。三段式提交对单点问题和回滚时的性能问题有所改善,但对一致性风险问题并未有任何改进,甚至是略有增加。譬如,进入 PreCommit 阶段之后,协调者发出的指令不是 Ack 而是 Abort,而此时因网络问题,有部分参与者直至超时都未能收到协调者的 Abort 指令,这些参与者将会错误地提交事务,这就产生了不同参与者之间数据不一致的问题。